Quanto costa davvero l’AI? Compute Allocation, costi, ROI e budget aziendale
This post has already been read 3 times!
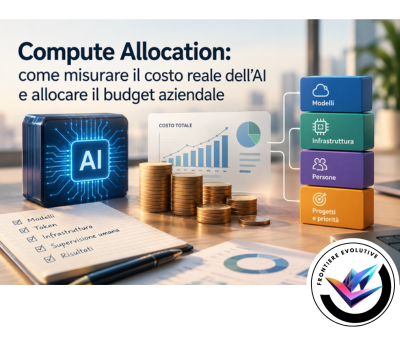
Compute Allocation: come misurare il costo reale dell’AI e allocare il budget aziendale
L’entusiasmo per l’intelligenza artificiale tende a cambiare quando un progetto supera la fase di sperimentazione e comincia a entrare nei processi quotidiani dell’azienda. All’inizio si pagano poche chiamate API, si prova un assistente interno, si modificano i prompt e si osservano i risultati senza preoccuparsi troppo del conto finale. Quando però il sistema viene utilizzato da centinaia o migliaia di persone, i contesti diventano più lunghi e gli agenti software iniziano a eseguire più passaggi per completare una singola attività, il costo del calcolo smette di essere una questione esclusivamente tecnica.
Diventa una variabile economica che deve essere misurata, attribuita ai diversi processi e confrontata con il valore prodotto.
Questo cambiamento è particolarmente importante nel 2026, perché la spesa per l’infrastruttura AI non riguarda più soltanto l’addestramento dei modelli. Gartner prevede per il 2026 circa 42,3 miliardi di dollari di spesa mondiale per infrastrutture IaaS ottimizzate per l’AI e stima che la spesa associata all’inference raggiunga 23,3 miliardi di dollari, superando i circa 19 miliardi destinati ai workload di training. La previsione indica quindi un passaggio sempre più evidente dalla costruzione dei modelli al loro utilizzo continuativo nei processi aziendali.
La domanda interessante non è più soltanto quanto costa un determinato modello, ma quanto costa ottenere un risultato operativo affidabile e quale valore produce quel risultato per l’organizzazione.
Quando il compute diventa una risorsa economica
Per molto tempo il calcolo è stato percepito come una componente infrastrutturale affidata soprattutto ai reparti IT. Con l’introduzione dell’AI nei processi aziendali, questa separazione diventa meno netta, perché la quantità di calcolo utilizzata da un processo dipende direttamente da come quel processo è stato progettato.
Un sistema che utilizza un modello leggero per classificare una richiesta e ricorre a un modello più costoso soltanto nei casi complessi può avere una struttura economica molto diversa da un sistema che invia ogni richiesta al modello più potente disponibile.
Lo stesso vale per gli agenti. Una richiesta che richiede una sola chiamata al modello ha un costo molto diverso da un processo nel quale l’agente interpreta l’obiettivo, interroga una base dati, genera una prima risposta, la verifica, recupera altre informazioni e ripete il ciclo prima di arrivare al risultato.
La quantità di compute utilizzata non dipende quindi soltanto dal modello scelto, ma anche dall’architettura del processo.
Per questo motivo il budget AI non dovrebbe essere costruito esclusivamente sulla base del prezzo dichiarato dal provider. Deve tenere conto dei volumi di utilizzo, della lunghezza dei contesti, della frequenza delle richieste, del numero di passaggi eseguiti dagli agenti, dell’utilizzo effettivo dell’infrastruttura e del tempo necessario alle persone per verificare i risultati.
Il contesto 2026: dall’addestramento all’inference
Il training è la fase nella quale un modello apprende dai dati. L’inference è invece l’esecuzione del modello già addestrato per produrre una previsione, una classificazione, una risposta o un’altra elaborazione.
La differenza economica è importante. Il training può essere concentrato in campagne periodiche, mentre l’inference cresce insieme al numero di utenti, richieste e processi automatizzati.
Il dato Gartner per il 2026 rende evidente questo cambiamento: secondo la previsione pubblicata nell’agosto 2026, la spesa mondiale per AI-optimized IaaS raggiungerà circa 42,3 miliardi di dollari e quella per inference circa 23,3 miliardi, contro circa 19 miliardi per il training. Gartner collega questa crescita anche alla maggiore diffusione di sistemi che eseguono processi articolati e continuativi.
Questo non significa che il training perda importanza. Significa piuttosto che, una volta portata l’AI nei processi produttivi, il problema economico si sposta progressivamente verso il costo della sua esecuzione quotidiana.
È una differenza simile a quella che esiste tra costruire una macchina e mantenerla in funzione per migliaia di ore: il costo iniziale è importante, ma quando l’utilizzo diventa continuo conta anche quanto costa ogni risultato prodotto.
Un glossario utile per parlare di compute
Il termine compute indica la capacità di calcolo utilizzata per svolgere un’attività. Può riguardare il training, l’inference, la preparazione dei dati o l’esecuzione di un processo automatico e può coinvolgere CPU, GPU, memoria, rete, storage e servizi di orchestrazione.
Le GPU sono particolarmente adatte a molti dei calcoli paralleli richiesti dai modelli di AI, ma il loro costo deve essere valutato insieme al tasso di utilizzo. Una risorsa acquistata o noleggiata che rimane inutilizzata per una parte consistente del tempo continua infatti a rappresentare un costo senza produrre una quantità equivalente di lavoro.
Le CPU rimangono invece adatte a numerose attività di preparazione, filtraggio, trasformazione dei dati e gestione dei flussi applicativi. Utilizzare una GPU per ogni fase di un processo non significa necessariamente ottenere un sistema più efficiente.
I token sono le unità attraverso cui i modelli linguistici elaborano il testo. I provider possono applicare prezzi diversi ai token di input e di output, quindi un contesto molto lungo può aumentare sensibilmente il costo anche quando la risposta generata è breve.
Un workload è un insieme di attività computazionali legate allo stesso processo aziendale, come la gestione dei ticket, l’analisi dei contratti o la preparazione di report. Ragionare per workload consente di passare dalla domanda generica “quanto ci costa l’AI?” a una domanda molto più utile: “quanto costa questa funzione e quale risultato produce?”
Un agente software può pianificare ed eseguire più azioni concatenate. Questa caratteristica aumenta le possibilità di automazione, ma può anche aumentare il numero di chiamate al modello. Un ciclo di verifiche ridondanti o una procedura progettata male può trasformare un’attività relativamente semplice in una sequenza computazionalmente costosa.
La latenza misura il tempo necessario per ottenere una risposta, mentre il throughput indica la quantità di lavoro elaborata in un determinato intervallo. Un processo batch notturno potrebbe non avere bisogno del modello più rapido disponibile, mentre un sistema utilizzato direttamente da un operatore può avere esigenze molto diverse.
Il costo del compute non coincide con il prezzo del modello
Il prezzo per milione di token è una metrica utile, ma non descrive da solo il costo economico di un caso d’uso.
Per una prima stima possiamo scrivere:
[math]\displaystyle \begin{aligned}
C_{\text{use case}} = N_{\text{esecuzioni}} \times C_{\text{esecuzione}}
\end{aligned}[/math]
Per un processo basato su API, il costo medio di un’esecuzione può essere rappresentato come:
[math]\displaystyle \begin{aligned}
C_{\text{esecuzione}} &= \frac{T_{\text{input}}}{10^6}P_{\text{input}} \\
&\quad + \frac{T_{\text{output}}}{10^6}P_{\text{output}}
\end{aligned}[/math]
dove [math]T[/math] rappresenta il numero medio di token e [math]P[/math] il prezzo applicato dal provider per un milione di token.
Questa formula è semplice, ma diventa rapidamente insufficiente quando il processo comprende più chiamate, recupero di informazioni, strumenti esterni o revisione umana.
Per un’infrastruttura GPU, per esempio, il costo dell’ora di lavoro effettiva può essere approssimato attraverso:
[math]\displaystyle \begin{aligned}
C_{\text{ora effettiva}} = \frac{P_{\text{GPU/h}}}{U}
\end{aligned}[/math]
dove [math]U[/math] rappresenta il tasso medio di utilizzo.
Se una GPU costa 3,50 euro all’ora e viene utilizzata mediamente al 30%, il costo dell’ora effettivamente utilizzata è circa 11,67 euro, prima di considerare rete, storage, gestione e altri servizi.
La formula non significa che la GPU diventi più costosa quando viene utilizzata poco. Significa che una parte della capacità acquistata non viene trasformata in lavoro produttivo e deve quindi essere considerata nel calcolo economico.
Dal costo per token al costo per risultato
Per una decisione aziendale il costo più interessante è spesso quello associato a un risultato verificabile.
Per l’assistenza clienti possiamo misurare il costo per ticket risolto, per la produzione di contenuti il costo per asset approvato, mentre per l’automazione possiamo calcolare il costo per attività completata senza correzioni sostanziali.
La formula è:
[math]\displaystyle \begin{aligned}
C_{\text{risultato}} = \frac{C_{\text{AI totale}}}{N_{\text{risultati validati}}}
\end{aligned}[/math]
La parola validati è fondamentale, perché un output generato dal sistema non coincide necessariamente con un risultato utilizzabile.
Se un sistema produce 10.000 risposte ma ogni risposta deve essere riletta e corretta da un operatore, il costo reale non può essere rappresentato soltanto dalla fattura del provider. Il tempo umano necessario per trasformare l’output in un risultato utilizzabile fa parte dell’economia del processo.
Questo cambia anche il modo in cui dovremmo valutare l’automazione.
Un sistema che genera più output non è necessariamente più efficiente. Potrebbe essere semplicemente un sistema che produce più materiale da controllare.
Il costo del controllo umano
Il controllo umano viene spesso considerato una fase accessoria, mentre in molti processi rappresenta una delle componenti economiche più importanti.
Supponiamo che un sistema produca una risposta corretta nel 90% dei casi, ma che ogni risposta debba essere controllata prima dell’invio. Se il controllo richiede due minuti per pratica, una parte significativa del vantaggio economico dell’automazione può essere assorbita dal lavoro umano.
Questo non significa che il sistema sia inutile. Il valore può derivare dalla maggiore velocità, dalla possibilità di gestire picchi di domanda o dalla capacità di permettere agli operatori di concentrarsi sui casi più complessi.
È però importante distinguere tra tre risultati diversi:
risparmio di cassa, quando l’automazione riduce effettivamente una spesa;
capacità liberata, quando le persone possono dedicare il tempo recuperato ad altre attività;
ricavo incrementale, quando la maggiore capacità o velocità produce effettivamente nuove entrate.
Confondere queste tre categorie porta facilmente a sovrastimare il ritorno economico di un progetto AI.
Una matrice per decidere dove destinare il compute
Un portafoglio AI può essere analizzato mettendo in relazione il costo mensile di un workload con il valore economico prodotto o stimato.
Gli importi della tabella sono esempi illustrativi.
| Caso d’uso | Costo mensile | Valore stimato | Rapporto valore/costo |
|---|---|---|---|
| Assistenza clienti | 1.200 € | 8.000 € | 6,7 |
| Analisi automatica dei dati | 900 € | 6.000 € | 6,7 |
| Generazione di contenuti | 1.500 € | 4.000 € | 2,7 |
| Previsioni interne | 700 € | 3.500 € | 5,0 |
| Sistema multi-agente | 3.000 € | 4.000 € | 1,3 |
| Sperimentazione libera | 2.000 € | 1.000 € | 0,5 |
Il rapporto può essere calcolato come:
[math]\displaystyle \begin{aligned}
R = \frac{V}{C}
\end{aligned}[/math]
dove [math]V[/math] è il valore attribuito al risultato e [math]C[/math] è il costo del compute e dei servizi direttamente associati.
Il rapporto non dovrebbe però diventare un meccanismo automatico con cui decidere il destino di ogni progetto. Un’attività di ricerca può avere un valore economico immediato ridotto e produrre conoscenza utile nel medio periodo, mentre un progetto legato alla sicurezza può avere un costo elevato senza generare direttamente ricavi.
Per questo conviene distinguere almeno tra valore realizzato, valore stimato, valore strategico e valore di apprendimento.
Questa distinzione permette di mantenere una certa disciplina economica senza pretendere che ogni progetto produca un ritorno finanziario immediato.
Quando un workload deve essere rivisto
Per i workload produttivi può essere utile definire una soglia minima di efficienza, indicata con [math]R_{\text{min}}[/math].
A titolo esemplificativo, un’organizzazione potrebbe adottare una regola interna secondo cui:
- quando [math]R \geq 3[/math], il workload può essere candidato a un’espansione, purché qualità e rischio rimangano sotto controllo;
- quando [math]1 \leq R < 3[/math], il workload entra in revisione e si valutano modelli più leggeri, contesti più brevi, caching o architetture differenti;
- quando [math]R < 1[/math], il costo supera il valore economico diretto e il processo deve essere giustificato da un beneficio strategico, di ricerca, sicurezza o conformità.
Queste soglie non rappresentano leggi economiche e non sono valide per tutte le organizzazioni. Devono essere calibrate considerando margini, costo del lavoro, qualità richiesta e conseguenze di eventuali errori.
La loro utilità consiste soprattutto nel rendere esplicito il criterio con cui l’organizzazione decide quando continuare a investire.
API, infrastruttura dedicata e punto di pareggio
Le API a consumo possono essere adatte a carichi discontinui, prototipi e processi il cui volume futuro non è ancora prevedibile. In questo modello il rischio di inattività dell’hardware rimane in larga parte a carico del provider e l’azienda paga in funzione dell’utilizzo.
Un’infrastruttura GPU dedicata può diventare interessante quando il carico è stabile e sufficientemente elevato, ma non esiste una soglia universale che permetta di stabilire quando una soluzione diventi automaticamente più conveniente dell’altra.
Il confronto dovrebbe considerare almeno:
[math]\displaystyle \begin{aligned}
C_{\text{API}} = N_{\text{token}} \times P_{\text{token}}
\end{aligned}[/math]
e
[math]\displaystyle \begin{aligned}
C_{\text{GPU}} &= C_{\text{istanza}} + C_{\text{storage}} \\
&\quad + C_{\text{rete}} + C_{\text{gestione}} + C_{\text{inattività}}
\end{aligned}[/math]
Il costo di gestione comprende il monitoraggio, gli aggiornamenti, la gestione degli errori, la sicurezza e la continuità operativa.
La domanda corretta non è quindi “quanto costa una GPU?”, ma “quanto costa produrre lo stesso volume di risultati affidabili con questa architettura?”
La variabilità dei consumi cambia il problema
La media storica non è sempre sufficiente.
Un agente può generare un numero variabile di chiamate, un nuovo cliente può aumentare rapidamente il volume di richieste e una campagna commerciale può produrre un picco temporaneo di utilizzo.
Per questo motivo il budget dovrebbe essere analizzato anche in termini probabilistici.
Un esempio puramente illustrativo potrebbe essere:
| Percentile | Spesa mensile stimata |
|---|---|
| P50 | 2.350 € |
| P75 | 2.800 € |
| P90 | 3.400 € |
| P95 | 3.900 € |
Il P50 rappresenta uno scenario centrale, mentre P90 e P95 descrivono livelli di spesa associati a scenari meno frequenti.
Per ottenere una vera simulazione Monte Carlo, tuttavia, è necessario definire le distribuzioni delle richieste, dei token, dei passaggi degli agenti e dei prezzi. Una semplice tabella di percentili non costituisce da sola una simulazione.
Un’organizzazione può utilizzare il valore centrale per il budget ordinario e mantenere una riserva per scenari di maggiore consumo, ma la dimensione della riserva deve dipendere dalla criticità del servizio e dalla possibilità di ridurre temporaneamente i workload non essenziali.
Budget, alert e protezione dai runaway costs
Il budget AI dovrebbe essere suddiviso per workload e non soltanto per reparto tecnico.
Consideriamo un budget complessivo di 10.000 euro.
| Attività | Budget iniziale | Consumo alla terza settimana | Quota consumata |
|---|---|---|---|
| Assistenza clienti | 2.500 € | 1.500 € | 60% |
| Analisi dati | 1.500 € | 900 € | 60% |
| Generazione contenuti | 1.500 € | 1.050 € | 70% |
| Previsioni interne | 1.000 € | 400 € | 40% |
| Sistema multi-agente | 1.500 € | 1.350 € | 90% |
| Sperimentazione | 1.000 € | 700 € | 70% |
| Riserva | 1.000 € | 0 € | 0% |
Se un workload ha già consumato il 90% del proprio budget alla terza settimana, la dashboard dovrebbe generare un avviso e richiedere una verifica.
Una regola semplice può essere:
[math]\displaystyle \begin{aligned}
\text{Stato} =
\begin{cases}
\text{OK} & \text{se } C < 0{,}8B\\
\text{ATTENZIONE} & \text{se } 0{,}8B \leq C < B\\
\text{REVISIONE} & \text{se } C \geq B
\end{cases}
\end{aligned}[/math]
dove [math]C[/math] è il consumo e [math]B[/math] il budget assegnato.
La governance dovrebbe inoltre distinguere tra notifiche informative, quote, rate limiting e veri blocchi di spesa, perché non tutti i servizi permettono di interrompere automaticamente ogni addebito.
Per gli agenti è particolarmente importante controllare anche la durata dei loop, il numero massimo di passaggi e le chiamate ripetute allo stesso strumento. Un errore di configurazione che moltiplica le chiamate può trasformarsi rapidamente in un runaway cost, cioè una crescita della spesa molto superiore a quella prevista.
Le metriche che permettono di capire se il sistema sta migliorando
Il monitoraggio non dovrebbe limitarsi alla spesa totale.
Tra le metriche più utili rientrano:
- costo per richiesta;
- costo per risultato validato;
- token medi di input e output;
- numero medio di passaggi per agente;
- tasso di utilizzo della GPU;
- latenza;
- tasso di errore;
- percentuale di risultati sottoposti a revisione;
- tempo medio di revisione umana;
- costo totale per workload.
Per l’assistenza clienti possiamo utilizzare:
[math]\displaystyle \begin{aligned}
C_{\text{ticket}} = \frac{C_{\text{AI}}}{N_{\text{ticket risolti e verificati}}}
\end{aligned}[/math]
Per la produzione di contenuti:
[math]\displaystyle \begin{aligned}
C_{\text{asset}} = \frac{C_{\text{AI}}}{N_{\text{contenuti approvati}}}
\end{aligned}[/math]
Per l’automazione:
[math]\displaystyle \begin{aligned}
C_{\text{task}} = \frac{C_{\text{AI}}}{N_{\text{task completati senza correzioni sostanziali}}}
\end{aligned}[/math]
Queste metriche diventano veramente utili quando vengono confrontate con un’alternativa concreta.
Se il costo per ticket risolto dall’AI è superiore al costo della gestione umana senza un miglioramento significativo in qualità, velocità o disponibilità, il processo richiede una revisione anche quando il sistema funziona tecnicamente.
Il nuovo lavoro nasce anche dal costo del compute
La diffusione dell’AI viene spesso associata alla crescita della domanda di AI engineer, sviluppatori di agenti, specialisti di machine learning e professionisti capaci di integrare modelli nei sistemi aziendali.
È una parte importante del cambiamento, ma non è l’unica.
Quando il numero di workload AI cresce, diventa necessario anche decidere come distribuire una risorsa costosa e limitata tra attività differenti.
Quale modello utilizzare per una determinata attività?
Quando un modello più piccolo è sufficiente?
Quando il controllo umano assorbe una parte troppo grande del beneficio?
Quando conviene utilizzare un’API e quando può avere senso un’infrastruttura dedicata?
Quanto compute assegnare a un agente?
Come gestire i picchi di consumo?
Come impedire che un errore di configurazione trasformi un processo in una fonte di costi non previsti?
Come misurare il valore prodotto dall’automazione?
Sono domande che non appartengono esclusivamente all’informatica. Richiedono una combinazione di conoscenze tecnologiche, economiche e organizzative.
Da questa intersezione può emergere una figura come il Compute Economist: un professionista capace di collegare capacità di calcolo, costi, workload, qualità del risultato e valore economico.
Il suo compito non sarebbe semplicemente cercare il modello meno costoso. Un modello economico può infatti diventare costoso se richiede più chiamate, contesti più lunghi o una quantità maggiore di supervisione umana.
Il problema è invece trovare il punto nel quale la capacità computazionale aggiuntiva produce un valore marginale sufficiente a giustificare il suo costo.
In questo senso, il Compute Economist si colloca tra tecnologia, controllo di gestione e progettazione dei processi.
La diffusione dell’AI potrebbe quindi creare una nuova categoria di competenze: non soltanto persone capaci di costruire sistemi intelligenti, ma anche persone capaci di decidere dove, quando e quanto farli funzionare.
Domande di colloquio sul Compute Allocation e sull’economia dell’AI
Il tema del compute non riguarda soltanto chi progetta infrastrutture AI. Può comparire nei colloqui per ruoli come AI Engineer, Machine Learning Engineer, Cloud Architect, Data Scientist, Product Manager, AI Product Manager, FinOps specialist e, sempre più spesso, per posizioni nelle quali è necessario collegare tecnologia e risultati economici.
In un colloquio non è sufficiente conoscere la formula del costo per token. È più importante dimostrare di saper collegare modello, workload, utilizzo, qualità del risultato, supervisione umana e valore economico.
Di seguito alcune domande che possono essere utilizzate per prepararsi a un colloquio o per valutare la preparazione di un candidato.
Qual è la differenza tra costo del modello e costo del risultato?
Il prezzo del modello rappresenta soltanto una componente del costo complessivo. Il costo del risultato deve includere, quando sono rilevanti, token, infrastruttura, orchestrazione, storage, monitoraggio, retry, integrazione e controllo umano.
Un candidato dovrebbe quindi evitare di rispondere semplicemente indicando il prezzo per milione di token e spiegare invece che la metrica più utile può essere il costo per risultato validato.
Come calcoleresti il costo di un workload AI?
Una prima approssimazione può partire da:
[math]\displaystyle C_{\text{workload}} = N_{\text{esecuzioni}} \times C_{\text{esecuzione}}[/math]
Nel caso di un’API linguistica, il costo di ogni esecuzione può dipendere separatamente dai token di input e di output. Se il sistema utilizza agenti, strumenti esterni o retry, bisogna considerare anche il numero effettivo di chiamate prodotte da una singola richiesta dell’utente.
Una risposta completa dovrebbe quindi distinguere tra richiesta dell’utente e numero reale di operazioni computazionali necessarie per completarla.
Perché il prezzo per token può essere una metrica insufficiente?
Perché due sistemi che utilizzano lo stesso modello possono avere costi molto diversi.
Un’applicazione può inviare contesti molto lunghi, effettuare più chiamate per ogni richiesta oppure utilizzare un agente che ripete alcune operazioni. Il prezzo unitario del token rimane invariato, ma il costo per risultato può aumentare sensibilmente.
La domanda economica diventa quindi quanto compute sia necessario per ottenere un risultato affidabile, non soltanto quanto costi una singola unità di consumo.
Quando utilizzeresti un modello più piccolo invece di uno più potente?
La scelta dovrebbe dipendere dal rapporto tra qualità richiesta e costo.
Se un modello più leggero raggiunge una qualità sufficiente per un determinato workload, il modello più potente potrebbe introdurre un costo aggiuntivo non giustificato dal miglioramento del risultato.
La valutazione dovrebbe però essere fatta sul processo completo. Un modello più economico che produce più errori e richiede maggiore revisione umana potrebbe risultare meno conveniente.
Come valuteresti se un sistema AI sta realmente riducendo i costi?
Partirei da una situazione di riferimento, cioè dal costo del processo prima dell’introduzione dell’AI, e confronterei il risultato con il costo complessivo del nuovo processo.
È importante distinguere tra:
- riduzione effettiva della spesa;
- capacità operativa liberata;
- aumento della produttività;
- ricavi aggiuntivi.
Il tempo risparmiato da un operatore non equivale automaticamente a un risparmio finanziario, soprattutto se il personale rimane invariato.
Come calcoleresti il costo per risultato validato?
Utilizzerei:
[math]\displaystyle C_{\text{risultato}} = \frac{C_{\text{AI totale}}}{N_{\text{risultati validati}}}[/math]
La parte più importante della risposta riguarda però la definizione di “risultato validato”.
Se una risposta generata dall’AI deve essere controllata e corretta da una persona prima di poter essere utilizzata, il tempo necessario per questa attività deve essere incluso nel costo.
Come confronteresti API e GPU dedicate?
Non confronterei semplicemente il prezzo di una chiamata API con il prezzo orario di una GPU.
Confronterei il costo totale di proprietà e gestione delle due alternative considerando volume, utilizzo previsto, storage, rete, gestione tecnica, inattività, disponibilità e requisiti operativi.
Le API possono essere convenienti per carichi variabili o difficili da prevedere, mentre un’infrastruttura dedicata può diventare interessante quando il carico è stabile e sufficientemente elevato.
La risposta migliore non dovrebbe indicare una soglia universale, perché il punto di pareggio dipende dal provider, dal modello, dal carico e dalla struttura dei costi.
Che cosa significa GPU utilization e perché è importante?
Il tasso di utilizzo indica quale parte della capacità disponibile viene effettivamente utilizzata.
Una GPU acquistata o noleggiata a tempo può continuare a generare costi anche quando rimane inattiva. Per questo il prezzo nominale dell’ora GPU non coincide necessariamente con il costo dell’ora di lavoro effettivamente prodotta.
Una risposta completa dovrebbe anche ricordare che aumentare l’utilizzo non è sempre sufficiente: bisogna verificare che la maggiore saturazione non provochi problemi di latenza o di qualità del servizio.
Come gestiresti un workload il cui consumo cresce improvvisamente?
Prima cercherei di identificare la causa dell’aumento.
Potrebbe trattarsi di un aumento reale della domanda, di un cambiamento nella lunghezza dei contesti, di retry eccessivi, di un loop di un agente, di un errore applicativo o di una configurazione che ha aumentato il numero di chiamate.
Successivamente introdurrei alert, quote, rate limiting e limiti sul numero di passaggi degli agenti, mantenendo eventualmente una riserva di capacità per i workload critici.
L’obiettivo non è bloccare automaticamente il sistema, ma evitare che una variazione non controllata del comportamento produca una spesa non prevista.
Che cosa sono i runaway costs?
Sono costi che crescono rapidamente oltre quanto previsto a causa di un aumento incontrollato dell’utilizzo.
Nel caso degli agenti possono derivare, per esempio, da loop, retry ripetuti, richieste duplicate o processi che continuano a effettuare chiamate senza raggiungere una condizione di terminazione.
Un sistema di governance dovrebbe prevedere almeno monitoraggio, soglie di consumo e meccanismi per limitare il numero di operazioni.
Perché il P90 può essere più utile della media per pianificare il budget?
La media descrive il consumo atteso in condizioni ordinarie, ma può nascondere eventi di picco.
Il P90 permette di ragionare su uno scenario nel quale la spesa è superiore a quella osservata nella maggior parte dei casi. Non significa che quel valore rappresenti una previsione certa, ma può essere utilizzato per valutare la riserva necessaria a gestire periodi di maggiore domanda.
Come assegneresti un budget a un agente AI?
Non partirei soltanto dal numero di utenti.
Considererei il numero previsto di attività, il numero medio di passaggi per attività, il costo delle chiamate, il tasso di retry, la frequenza degli errori, il costo della supervisione e il valore prodotto dalle attività completate.
Il budget dovrebbe inoltre essere accompagnato da un limite operativo sul numero di passaggi o sulle risorse che l’agente può utilizzare.
Come valuteresti il ROI di un sistema AI?
Partirei dal beneficio incrementale e dal costo complessivo necessario per ottenere quel beneficio:
[math]\displaystyle ROI = \frac{B-C}{C}\times100[/math]
La difficoltà non è nella formula, ma nella definizione di [math]B[/math].
Se il beneficio deriva dal tempo risparmiato dagli operatori, bisogna stabilire se quel tempo genera realmente un risparmio di cassa, maggiore capacità produttiva o ricavi aggiuntivi.
Un candidato dovrebbe quindi evitare di presentare un ROI calcolato su ipotesi non verificate come se fosse un risultato finanziario certo.
Un ROI elevato dimostra che un progetto AI è conveniente?
Non necessariamente.
Il ROI dipende dalle ipotesi utilizzate per stimare benefici e costi. Se il beneficio attribuito al progetto deriva soprattutto dalla valorizzazione teorica delle ore risparmiate, il risultato deve essere interpretato diversamente rispetto a un beneficio rappresentato da ricavi incrementali effettivamente osservati.
È quindi utile affiancare al ROI un’analisi di sensibilità e distinguere tra valori osservati e valori stimati.
Quali metriche utilizzeresti per monitorare un workload AI?
Una risposta completa potrebbe includere:
- costo totale;
- costo per richiesta;
- costo per risultato validato;
- token medi di input e output;
- numero medio di passaggi per agente;
- tasso di retry;
- utilizzo GPU;
- latenza;
- tasso di errore;
- percentuale di revisione umana;
- tempo medio di revisione;
- valore prodotto dal workload.
La scelta delle metriche dovrebbe comunque dipendere dal processo. Non tutti i workload richiedono lo stesso sistema di misurazione.
Come capiresti se un agente sta utilizzando troppo compute?
Confronterei il consumo osservato con quello atteso per attività equivalenti e analizzerei la struttura delle chiamate.
Un aumento del numero medio di passaggi, dei token utilizzati o dei retry può indicare che l’agente sta diventando più costoso senza produrre un miglioramento equivalente del risultato.
La metrica interessante non sarebbe quindi soltanto il costo per esecuzione, ma il costo per attività completata correttamente.
Qual è il ruolo del controllo umano nell’economia dell’AI?
Il controllo umano deve essere considerato parte del processo e quindi, quando rappresenta una componente necessaria, anche del suo costo.
Un sistema che riduce il tempo di generazione ma richiede un controllo manuale molto lungo potrebbe produrre un vantaggio inferiore a quello inizialmente previsto.
Il punto non è eliminare necessariamente il controllo umano, ma capire quali attività possono essere automatizzate completamente e quali richiedono una supervisione proporzionata al rischio.
Che cosa dovrebbe fare un Compute Economist?
Il Compute Economist dovrebbe collegare capacità computazionale, costi, workload e valore prodotto.
Tra le sue attività potrebbero rientrare la valutazione economica dei modelli, il confronto tra API e infrastruttura dedicata, l’analisi dei consumi, la definizione dei budget, il monitoraggio dei costi, la gestione dei picchi e la valutazione economica dei workload AI.
La caratteristica distintiva di questa figura non sarebbe conoscere soltanto il funzionamento dei modelli, ma riuscire a tradurre una scelta tecnica in una conseguenza economica e organizzativa.
Se il costo dell’AI aumenta, la prima soluzione è utilizzare un modello più economico?
Non necessariamente.
Prima di cambiare modello bisognerebbe capire da dove nasce l’aumento del costo.
Potrebbe dipendere dall’aumento del numero di richieste, da contesti troppo lunghi, da retry, da un agente che esegue troppi passaggi, da una scarsa utilizzazione dell’infrastruttura o da un aumento della revisione umana.
In alcuni casi la soluzione può essere un modello più leggero, ma in altri può essere più efficace ridurre il contesto, introdurre caching, modificare l’architettura o eliminare passaggi che non producono valore.
Qual è la differenza tra ottimizzare il costo e ottimizzare il valore?
Ottimizzare il costo significa cercare di ottenere lo stesso risultato utilizzando meno risorse.
Ottimizzare il valore significa invece valutare se una maggiore spesa produca un miglioramento sufficientemente grande del risultato.
Un modello più costoso può essere economicamente sensato se aumenta abbastanza la qualità, riduce gli errori o elimina una parte significativa del lavoro umano.
La domanda quindi non dovrebbe essere “come spendere meno?”, ma “come ottenere il miglior rapporto tra compute utilizzato e valore prodotto?”
Domanda finale: come spiegheresti in un minuto perché il compute sta diventando una competenza manageriale?
Una risposta efficace potrebbe essere formulata così:
Il compute sta diventando una competenza manageriale perché l’AI non è più soltanto un software che acquistiamo, ma una capacità operativa che consumiamo continuamente. Quando aumentano utenti, agenti e workload, bisogna decidere quali processi meritano più capacità di calcolo, quale modello utilizzare, quanto spendere e quale valore aspettarsi. Per questo la gestione del compute richiede un collegamento tra tecnologia, costi, qualità e risultati aziendali. Il problema non è utilizzare meno compute possibile, ma allocarlo dove produce il maggiore valore marginale.
Questa è anche la ragione per cui il tema del Compute Allocation va oltre la semplice ottimizzazione dell’infrastruttura: descrive una competenza che potrebbe diventare sempre più importante nelle organizzazioni che utilizzano l’AI su scala.
Un caso aziendale: 20.000 ticket al mese
Consideriamo un servizio di assistenza clienti che gestisce 20.000 ticket al mese.
Un’analisi preliminare mostra che il 60% dei ticket può essere trattato dal sistema AI, mentre il restante 40% richiede competenze o autorizzazioni che devono rimanere in carico agli operatori.
Il sistema non viene considerato autonomo semplicemente perché genera una risposta. Un risultato viene conteggiato come valido soltanto quando il ticket viene risolto senza una correzione sostanziale da parte dell’operatore.
Nel mese osservato vengono quindi elaborati 12.000 ticket.
Il tasso di risoluzione verificata è del 75%, per un totale di:
[math]\displaystyle \begin{aligned}
12.000 \times 0{,}75 = 9.000
\end{aligned}[/math]
ticket chiusi attraverso il flusso AI.
Prima dell’introduzione del sistema, il costo medio interno per la gestione di un ticket era stimato in 4,50 euro.
Il valore teorico del lavoro evitato diventa quindi:
[math]\displaystyle \begin{aligned}
B_{\text{lavoro evitato}} = 9.000 \times 4{,}50 = 40.500\ \text{€}
\end{aligned}[/math]
Questa cifra deve essere interpretata con attenzione.
Se gli operatori liberati dai ticket non vengono riallocati su attività produttive e il numero di dipendenti rimane invariato, 40.500 euro non rappresentano automaticamente un risparmio di cassa.
Possono rappresentare invece capacità operativa liberata.
La distinzione è fondamentale quando si calcola il ritorno economico di un progetto AI.
Il costo mensile dell’inference
Supponiamo, a scopo illustrativo, che ogni richiesta utilizzi mediamente 3.500 token di input e 450 token di output.
Ipotizziamo inoltre un prezzo di 0,80 euro per milione di token in ingresso e 3 euro per milione di token in uscita.
Il costo nominale di una richiesta è:
[math]\displaystyle \begin{aligned}
C_{\text{richiesta}} &= \frac{3.500}{1.000.000}\times 0{,}80 \\
&\quad + \frac{450}{1.000.000}\times 3 = 0{,}00415\ \text{€}
\end{aligned}[/math]
Per 12.000 richieste il costo nominale dei token sarebbe quindi circa 49,80 euro.
Se il 15% delle richieste genera una seconda chiamata per un controllo, un recupero di informazioni o un nuovo tentativo, il costo sale a circa 57,27 euro.
Ma questo non rappresenta il costo complessivo del sistema.
| Voce di costo | Importo mensile |
|---|---|
| Token di input e output | 57,27 € |
| Monitoraggio, log e storage | 600 € |
| Revisione umana | 3.000 € |
| Gestione tecnica e manutenzione | 1.500 € |
| Quota mensile dell’integrazione iniziale | 2.000 € |
| Costo totale | 7.157,27 € |
La voce relativa alla revisione umana è particolarmente importante, perché dimostra come il costo del modello possa essere una frazione molto piccola del costo complessivo del processo.
Anche l’integrazione iniziale dovrebbe essere distribuita su un periodo definito, per esempio dodici o ventiquattro mesi, invece di scomparire dai calcoli subito dopo il lancio.
Il costo medio per ticket risolto attraverso il flusso AI diventa:
[math]\displaystyle \begin{aligned}
C_{\text{ticket risolto}} = \frac{7.157{,}27}{9.000} \approx 0{,}80\ \text{€}
\end{aligned}[/math]
ROI, beneficio netto e periodo di recupero
Supponiamo inoltre che il sistema produca un beneficio ulteriore stimato in 2.400 euro mensili grazie alla riduzione delle escalation e al miglioramento dei tempi di risposta.
Il beneficio complessivo stimato diventa:
[math]\displaystyle \begin{aligned}
B_{\text{totale}} = 40.500 + 2.400 = 42.900\ \text{€}
\end{aligned}[/math]
Il ROI teorico mensile, applicando direttamente queste ipotesi, è:
[math]\displaystyle \begin{aligned}
ROI = \frac{B_{\text{totale}} – C_{\text{totale}}}{C_{\text{totale}}} \times 100
\end{aligned}[/math]
e quindi:
[math]\displaystyle \begin{aligned}
ROI &= \frac{42.900 – 7.157{,}27}{7.157{,}27} \times 100 \\
&\approx 499\%
\end{aligned}[/math]
Il risultato è matematicamente coerente con le ipotesi dell’esempio, ma non deve essere interpretato come un rendimento finanziario certo del 499%.
Il motivo è importante: una parte consistente del beneficio deriva dalla valorizzazione del tempo liberato dagli operatori.
Se quel tempo non viene trasformato in una riduzione effettiva dei costi, in una maggiore capacità produttiva o in ricavi aggiuntivi, il beneficio economico reale sarà diverso.
Il beneficio netto teorico del caso è circa 35.742,73 euro al mese.
Se l’investimento iniziale per progettazione, integrazione e formazione ammontasse a 24.000 euro, il payback teorico sarebbe:
[math]\displaystyle \begin{aligned}
Payback = \frac{24.000}{35.742{,}73} \approx 0{,}67\ \text{mesi}
\end{aligned}[/math]
Anche in questo caso il numero deve essere letto come risultato dello scenario costruito, non come previsione.
Un payback così rapido richiederebbe infatti una verifica particolarmente attenta delle ipotesi sul valore del lavoro evitato.
Il punto di pareggio
Il break-even permette di porre una domanda più concreta: quanti risultati validati sono necessari per coprire il costo mensile?
Se il beneficio medio attribuito a una risoluzione valida è di 4,50 euro:
[math]\displaystyle \begin{aligned}
N_{\text{break-even}} = \frac{C_{\text{totale}}}{B_{\text{medio per risultato}}}
\end{aligned}[/math]
quindi:
[math]\displaystyle \begin{aligned}
N_{\text{break-even}} = \frac{7.157{,}27}{4{,}50} \approx 1.591
\end{aligned}[/math]
Il sistema dovrebbe quindi produrre circa 1.591 risoluzioni valide al mese per coprire i costi operativi indicati.
Nel caso osservato ne produce 9.000, ma il margine economico dipende dalla validità dell’ipotesi secondo cui ogni risoluzione rappresenti realmente 4,50 euro di costo evitabile.
L’analisi di sensibilità
Un singolo ROI può essere fuorviante quando dipende da diverse ipotesi.
Nel caso dell’assistenza clienti, le variabili più importanti sono il tasso di risoluzione verificata, il costo medio del ticket, il volume delle richieste, il numero di token e il tempo necessario per la revisione umana.
Una semplice analisi di scenario può mostrare quanto cambia il risultato.
| Scenario | Risoluzioni valide | Beneficio totale stimato | Costo totale | ROI indicativo |
|---|---|---|---|---|
| Prudente | 5.400 | 26.700 € | 7.157 € | 273% |
| Centrale | 9.000 | 42.900 € | 7.157 € | 499% |
| Favorevole | 10.200 | 48.300 € | 7.157 € | 575% |
Anche questa tabella non deve essere interpretata come una previsione statistica. Serve a mostrare quanto il risultato dipenda dalle ipotesi iniziali.
Per rendere il modello aggiornabile, il foglio di lavoro dovrebbe contenere almeno:
- ticket mensili;
- percentuale di ticket eleggibili;
- tasso di risoluzione verificata;
- costo umano evitabile;
- token medi in ingresso;
- token medi in uscita;
- prezzo dei token;
- percentuale di retry;
- costo della revisione;
- costi tecnici ricorrenti;
- quota dell’investimento iniziale.
Sarebbe inoltre utile mostrare separatamente il ROI calcolato sul risparmio di cassa e quello calcolato sulla capacità operativa liberata, perché le due misure rispondono a domande differenti.
Prima di aumentare il compute
Prima di aumentare la capacità di calcolo di un workload conviene verificare che il processo produca un risultato misurabile e che il valore attribuito a quel risultato sia stato calcolato attraverso criteri espliciti.
È inoltre necessario verificare che esista un limite di spesa oppure un meccanismo equivalente basato su quote, rate limiting o blocchi applicativi.
Prima di utilizzare un modello più grande, vale la pena verificare se un modello più leggero, una riduzione del contesto, il caching o una procedura deterministica possano svolgere la stessa parte del lavoro.
Quando un agente aumenta il numero di passaggi, bisogna chiedersi se ogni passaggio aggiuntivo produca effettivamente valore oppure se stia soltanto aumentando la spesa.
La scelta tra API e infrastruttura dedicata dovrebbe essere motivata da un confronto economico che includa il tasso di utilizzo atteso e i costi indiretti.
Infine, il budget dovrebbe essere verificato anche contro uno scenario di traffico elevato, almeno a livello P90, in modo da evitare che un mese anomalo comprometta la continuità del servizio.
La regola del portafoglio compute
La gestione dell’intelligenza artificiale in azienda richiede un cambiamento di prospettiva.
Il compute non è soltanto una spesa tecnica da ridurre. È una risorsa da distribuire tra attività che hanno valore, rischio, variabilità e orizzonti temporali differenti.
Ogni workload dovrebbe essere valutato almeno lungo quattro dimensioni.
La prima è il valore, che può essere economico, operativo, strategico o legato all’apprendimento.
La seconda è il costo, calcolato sulla base dell’utilizzo reale e non soltanto del listino del provider.
La terza è la variabilità, cioè l’esposizione a picchi di traffico, retry, comportamenti degli agenti e altre fonti di consumo difficili da prevedere.
La quarta è la strategicità, che comprende la possibilità di costruire competenze, ridurre rischi futuri o preparare capacità che avranno valore in seguito.
Questa prospettiva porta a una conclusione diversa dalla semplice ricerca del modello più economico.
Un modello più economico non è necessariamente la soluzione più efficiente, così come un modello più potente non è necessariamente quella più produttiva.
La domanda diventa:
quanto compute aggiuntivo serve per ottenere quanto valore aggiuntivo?
È questo il punto nel quale l’economia del compute incontra la progettazione dei processi.
Il compute diventa una competenza manageriale
Quando l’AI era confinata soprattutto alla sperimentazione, la domanda principale poteva essere quale modello fosse tecnicamente migliore.
Quando decine di workload entrano nei processi aziendali, la domanda cambia.
Bisogna decidere quali attività meritano un modello sofisticato, quali possono essere affidate a un modello più leggero, quali richiedono supervisione umana e quali non hanno ancora dimostrato un valore sufficiente.
Bisogna anche decidere quanta capacità riservare alla produzione, quanta alla sperimentazione e quanta mantenere come margine per affrontare picchi o situazioni impreviste.
Questo significa che la gestione del compute entra progressivamente nello stesso territorio nel quale si incontrano budget, rischio, produttività e strategia.
Il futuro dell’AI nelle organizzazioni non dipenderà quindi soltanto dalla capacità di costruire sistemi più potenti.
Dipenderà anche dalla capacità di assegnare la giusta quantità di capacità computazionale al problema giusto, nel momento giusto e a un costo compatibile con il valore prodotto.
È qui che può trovare spazio una figura come il Compute Economist, ma anche una competenza più ampia che potrebbe diffondersi tra CIO, responsabili AI, controller, product manager e responsabili delle operations: la capacità di ragionare sul compute non come una semplice risorsa tecnica, ma come una componente economica del processo.
La nuova regola dell’AI aziendale
Il punto non è utilizzare meno compute a qualsiasi costo.
Un sistema troppo economico ma incapace di raggiungere la qualità richiesta può produrre più lavoro umano, più errori e più costi indiretti.
Allo stesso modo, un sistema sovradimensionato può consumare risorse senza produrre un valore proporzionato.
L’obiettivo è trovare una relazione sostenibile tra capacità computazionale, qualità, costo e valore.
Per questo la regola di un portafoglio AI maturo può essere formulata in modo semplice:
Allocare la capacità di calcolo in funzione del valore marginale prodotto, non della facilità con cui può essere consumata.
Un sistema AI sostenibile non è quello che utilizza sempre il modello più potente o l’infrastruttura più grande.
È quello nel quale ogni aumento di capacità è collegato a un risultato osservabile, ogni costo rilevante può essere attribuito a un processo, i picchi di consumo possono essere gestiti e ogni eccezione può essere spiegata attraverso una ragione comprensibile.
Il vero cambiamento non riguarda quindi soltanto il modo in cui le aziende utilizzano l’intelligenza artificiale.
Riguarda anche il modo in cui imparano a decidere quanto calcolo vale la pena acquistare, per quali attività e con quale ritorno atteso.
In questo senso, il compute non è più soltanto l’infrastruttura sulla quale gira l’AI.
Sta diventando una delle risorse economiche che determineranno quali sistemi verranno realmente portati su scala e quali resteranno esperimenti.
Riferimenti
- Gartner, Forecast Analysis: AI-Optimized IaaS, Worldwide, 2026.
- Deloitte, Why AI’s next phase will likely demand more computational power, not less.
Nota editoriale: i valori economici riportati nelle tabelle operative e nel caso aziendale sono esempi illustrativi. I prezzi di API, GPU e servizi infrastrutturali devono essere aggiornati in base al provider, alla regione, alla modalità di fatturazione, al livello di utilizzo e alla data del rilevamento.
📚 Per approfondire: AI agentica, compute e infrastrutture del futuro
L’evoluzione dell’intelligenza artificiale non riguarda soltanto i modelli, ma anche l’architettura degli agenti, la potenza di calcolo, l’energia e le infrastrutture che rendono possibile la loro crescita. Questi articoli approfondiscono i diversi aspetti di questa trasformazione:
👉 Compute Economist: chi è e perché la potenza di calcolo sta ridefinendo l’economia dell’AI
👉 Agenti AI: perché il modello conta meno dell’architettura
👉 La nuova geopolitica dei data center: energia, chip e AI ridisegnano il potere globale
👉 Tumix di Google: l’AI non scala più, si organizza. Il futuro multi-agente






 La Nuova Geopolitica dei Data Center: Energia, Chip e AI Ridisegnano il Potere Globale (e l'Italia rischia il blackout)
 Capitale Algoritmico: Nel 2026 il lavoro non scompare. Diventa invisibile
 Co-evoluzione cognitiva: come cambia la matematica e il ragionamento con l’IA
 AI Scheming: che cos'è e perché l'intelligenza artificiale impara a mentire
 Dal Prodotto all'Ecosistema: La Matematica del Lock-In nel Business Digitale
 Sicurezza degli Agenti AI: Perché un Modello "Bravo" può Distruggere la tua Azienda
 Data Cruncher Cercasi Disperatamente: perché l’Analisi Dati oggi non basta più
 ClawBench svela il limite degli agenti AI: perché falliscono il 67% dei task reali e cosa devono fare le aziende nel 2026