Digital Twin nelle PMI: simulare processi, magazzino e investimenti prima di decidere
This post has already been read 12 times!
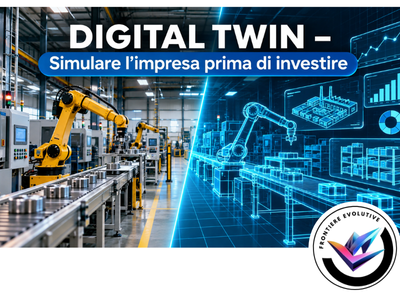
Dal gemello digitale di un prodotto alla simulazione di un magazzino, le piccole e medie imprese possono utilizzare i Digital Twin per valutare alternative, individuare inefficienze e ridurre i rischi degli investimenti. Non servono necessariamente impianti complessi o costose piattaforme tridimensionali: il punto di partenza è un problema aziendale concreto, da rappresentare attraverso dati, modelli e scenari verificabili.
La prossima decisione aziendale potrebbe essere provata prima
Immaginiamo una piccola impresa manifatturiera con 35 dipendenti. Gli ordini sono in aumento, il magazzino è congestionato e il responsabile della produzione propone di acquistare una nuova macchina da 85.000 euro, senza considerare i costi di installazione, formazione e manutenzione. Il titolare, tuttavia, non è convinto che l’attuale capacità produttiva sia davvero il problema: i ritardi potrebbero dipendere dalla disponibilità dei materiali, dai tempi di attrezzaggio oppure dalla sequenza con cui gli ordini attraversano le diverse fasi di lavorazione.
L’investimento potrebbe risolvere il problema, ma potrebbe anche aggiungere capacità in un punto che non rappresenta il vero collo di bottiglia. Prima di impegnare una somma importante, l’impresa potrebbe ricostruire il funzionamento del processo produttivo attraverso un modello digitale, modificare alcune condizioni operative e confrontare i risultati di scenari alternativi. Non otterrebbe una certezza su ciò che accadrà, perché domanda, fornitori e condizioni produttive continueranno a essere soggetti a variabilità, ma avrebbe a disposizione informazioni più solide per valutare le conseguenze delle proprie decisioni.
È in questo contesto che entra in gioco il Digital Twin, o gemello digitale. Il suo valore non consiste necessariamente nel creare una copia tridimensionale dello stabilimento, con macchinari virtuali che si muovono sullo schermo, ma nella possibilità di rappresentare le relazioni tra ordini, scorte, persone, tempi di lavorazione e vincoli produttivi, così da comprendere come una modifica potrebbe influire sull’intero sistema.
Questa prospettiva attribuisce alla trasformazione digitale un significato più concreto rispetto alla semplice introduzione di nuove tecnologie. Un’impresa non diventa più competitiva perché acquista un software sofisticato, ma perché riesce a utilizzare le informazioni disponibili per prendere decisioni migliori, individuare gli investimenti realmente necessari e verificare in anticipo le conseguenze delle alternative considerate.
Quando un modello digitale diventa un Digital Twin
Con Digital Twin si indica una rappresentazione digitale di un oggetto, un processo o un sistema fisico, collegata in qualche misura alle informazioni provenienti dalla realtà. Il modello può essere utilizzato per monitorare il comportamento del sistema, analizzarne le prestazioni, simulare condizioni differenti e, nelle implementazioni più avanzate, contribuire a modificare il funzionamento del processo fisico.
La distinzione tra modello digitale, Digital Shadow e Digital Twin è utile per comprendere i diversi livelli di integrazione tra realtà e rappresentazione virtuale, anche se la letteratura scientifica non adotta una classificazione completamente uniforme.
Un modello digitale può essere aggiornato manualmente oppure attraverso l’importazione periodica di dati provenienti dai sistemi aziendali. Una Digital Shadow introduce un collegamento automatico prevalentemente unidirezionale: quando nel sistema fisico si verifica un movimento di magazzino o cambia lo stato di una macchina, l’informazione viene trasferita alla rappresentazione digitale. Nel Digital Twin in senso più integrato, invece, lo scambio di informazioni può avvenire in entrambe le direzioni, consentendo al modello di restituire indicazioni o comandi al sistema fisico, secondo le autorizzazioni e i controlli previsti.
Un esempio aiuta a distinguere queste situazioni. Se il responsabile di un magazzino aggiorna periodicamente un foglio di calcolo con le giacenze, dispone di un modello digitale del processo. Se i movimenti registrati nel gestionale aggiornano automaticamente la rappresentazione, si introduce una Digital Shadow. Se il sistema integra anche modelli di simulazione, riceve informazioni aggiornate e può suggerire o inviare modifiche operative attraverso un’infrastruttura controllata, ci si avvicina a un Digital Twin più completo.
Una dashboard che mostra ordini, giacenze e fatturato può essere molto utile per monitorare l’attività aziendale, ma non costituisce automaticamente un gemello digitale. La dashboard descrive indicatori e andamento, mentre un modello di simulazione permette anche di modificare alcune condizioni e osservare gli effetti possibili. Allo stesso modo, una simulazione alimentata con dati storici ma non collegata agli aggiornamenti del sistema reale rappresenta un modello digitale o un prototipo di simulazione, non necessariamente un Digital Twin integrato.
Questa distinzione non deve diventare un ostacolo per le imprese che intendono iniziare un progetto di questo tipo. Pretendere fin dall’inizio una rappresentazione completa, aggiornata in tempo reale e collegata bidirezionalmente a ogni componente aziendale significherebbe spesso affrontare costi e complessità non giustificati dai benefici attesi.
Per le piccole e medie imprese può essere più ragionevole partire da una rappresentazione circoscritta a un processo o a una decisione. Il concetto di Partial Twin, proposto proprio per favorire un’adozione pragmatica nelle PMI, segue questa impostazione: modellare soltanto gli elementi necessari per rispondere a una domanda concreta, lasciando fuori tutto ciò che non contribuisce alla decisione.
Per comprendere meglio che cosa distingue un Digital Twin da un normale modello di simulazione, conviene osservare come cambia il rapporto tra la rappresentazione digitale e il sistema fisico, considerando anche il modo in cui le informazioni vengono scambiate tra i due.
Simulazione e Digital Twin: due strumenti collegati, ma non equivalenti
La differenza tra simulazione e Digital Twin riguarda soprattutto il rapporto tra il modello digitale e il sistema fisico che rappresenta. Una simulazione utilizza un modello matematico o computazionale per riprodurre il comportamento di un processo, modificare alcune variabili e osservare che cosa potrebbe accadere in condizioni differenti. Può lavorare con dati storici, parametri definiti dall’analista e scenari ipotetici, senza essere collegata in modo continuativo all’impianto o al processo aziendale.
Un Digital Twin, invece, mantiene una relazione strutturata con uno specifico sistema fisico e aggiorna la propria rappresentazione attraverso lo scambio di informazioni con la realtà. La simulazione può essere utilizzata al suo interno per prevedere gli effetti di una modifica, confrontare alternative o individuare possibili anomalie, ma il valore aggiuntivo deriva dal collegamento con il sistema reale e dalla capacità di mantenere il modello coerente con la sua evoluzione.
La distinzione può essere osservata attraverso tre configurazioni:
| Configurazione | Collegamento con la realtà | Funzione principale |
|---|---|---|
| Modello di simulazione | Nessun aggiornamento automatico dal sistema fisico | Analizzare scenari e confrontare alternative |
| Digital Shadow | Aggiornamento automatico dal sistema fisico al modello digitale | Monitorare e rappresentare lo stato del sistema |
| Digital Twin | Scambio di informazioni tra sistema fisico e rappresentazione digitale, potenzialmente in entrambe le direzioni | Monitorare, prevedere e supportare o, nei sistemi più integrati, attuare interventi |
Questa classificazione è una delle più diffuse in letteratura, anche se esistono definizioni differenti e livelli intermedi di integrazione. In particolare, non tutti i Digital Twin devono necessariamente intervenire in modo automatico sul sistema fisico: possono anche elaborare analisi e fornire indicazioni a un operatore, che mantiene la responsabilità della decisione.
La differenza, quindi, non dipende dalla complessità del software, dalla presenza di una visualizzazione tridimensionale o dalla sofisticazione dell’algoritmo di simulazione. Dipende soprattutto da quanto il modello sia collegato al sistema reale, da come vengono aggiornate le informazioni e da quale ruolo svolga nel supportare le decisioni operative.
Lo stesso magazzino, tre livelli tecnologici
Riprendiamo il caso del distributore di componenti tecnici con 1.200 referenze. Lo stesso processo di gestione delle scorte può essere affrontato con strumenti differenti, che corrispondono a livelli progressivi di integrazione tra modello digitale e realtà operativa.
Livello 1 – Simulazione: il modello offline
L’azienda importa dal gestionale le vendite degli ultimi dodici mesi, costruisce un modello delle scorte e confronta tre politiche di riordino. Può valutare gli effetti delle alternative e stimare come cambierebbero disponibilità, capitale immobilizzato e livello di servizio, ma il modello non conosce automaticamente le giacenze aggiornate durante la giornata. Ogni nuova analisi richiede quindi l’importazione di dati aggiornati o la modifica manuale dei parametri.
Livello 2 – Digital Shadow: il magazzino monitorato
Le giacenze, gli ordini e i movimenti vengono aggiornati automaticamente nel modello digitale attraverso il collegamento con il gestionale o con altri sistemi aziendali. Il responsabile può osservare una rappresentazione coerente con lo stato del magazzino e individuare situazioni critiche, ma il flusso informativo procede principalmente dal sistema fisico verso quello digitale: il modello non restituisce automaticamente modifiche alle operazioni reali.
Livello 3 – Digital Twin: il magazzino connesso e interattivo
Il modello riceve gli aggiornamenti operativi, simula gli effetti di variazioni della domanda e dei tempi di consegna e restituisce indicazioni sulle politiche di riordino. Il responsabile può valutare e approvare le proposte, mentre nelle configurazioni più avanzate, se il sistema è stato progettato, autorizzato e verificato per farlo, alcune decisioni possono essere trasferite automaticamente ai sistemi operativi.
L’esempio mostra perché una simulazione non diventa automaticamente un Digital Twin soltanto perché utilizza dati aziendali. Il passaggio decisivo riguarda la continuità del collegamento con il sistema fisico e la possibilità di utilizzare le informazioni elaborate per supportare, e in alcuni casi attuare, decisioni sul processo reale.
Dal prodotto al magazzino: dove può essere utile

Un gemello digitale può riguardare un prodotto, una linea di produzione, un magazzino oppure una parte della catena di fornitura. La scelta dipende dalle caratteristiche dell’impresa e, soprattutto, dalle decisioni che generano costi ricorrenti, inefficienze o investimenti difficili da recuperare.
Nel caso di un prodotto, la rappresentazione digitale può riunire caratteristiche tecniche, materiali, componenti, fasi di lavorazione e costi. Un’impresa che sta valutando l’introduzione di una lega meno costosa, per esempio, può confrontare materiali alternativi considerando peso, lavorabilità, resistenza e conseguenze sulle successive fasi produttive. Il modello può contribuire a individuare incompatibilità o problemi prima che la modifica venga introdotta nella produzione, purché le simulazioni siano basate su informazioni tecniche attendibili.
Nella produzione, il gemello digitale può descrivere capacità delle macchine, turni, tempi di attrezzaggio, fermi, sequenze degli ordini e vincoli tra lavorazioni. L’impresa può valutare che cosa accadrebbe in caso di fermo di una macchina per alcune ore, introduzione di un secondo turno o modifica delle priorità di produzione.
Un aspetto particolarmente importante riguarda l’individuazione dei colli di bottiglia. Una linea produttiva non è necessariamente limitata dalla macchina più vecchia o da quella con la capacità nominale inferiore, perché il vincolo effettivo può dipendere da una fase condivisa da più prodotti, da un’attrezzatura disponibile soltanto in determinati orari oppure da tempi di attesa tra lavorazioni. Acquistare un nuovo macchinario senza considerare queste relazioni potrebbe aumentare la capacità teorica senza migliorare il numero di ordini effettivamente evasi.
Il magazzino rappresenta un’altra applicazione interessante, soprattutto perché molte informazioni necessarie sono già presenti nel gestionale o nei fogli di calcolo. Giacenze, ubicazioni, frequenza dei prelievi, ordini in attesa, tempi di ricevimento e affidabilità dei fornitori costituiscono una base informativa dalla quale partire per costruire un primo modello.
Attraverso la simulazione è possibile confrontare politiche di riordino, configurazioni del layout e percorsi di picking, oppure valutare come un aumento della domanda e un ritardo nelle consegne potrebbero modificare il fabbisogno di scorte. In questo caso, il modello può aiutare a comprendere se l’impresa abbia realmente bisogno di acquistare più merce oppure se una migliore organizzazione delle ubicazioni e delle attività di prelievo sia sufficiente a migliorare il servizio.
Anche la supply chain può essere rappresentata attraverso un gemello digitale, ma questa applicazione presenta una difficoltà aggiuntiva: le informazioni dipendono da soggetti esterni, come fornitori, trasportatori e distributori, che non sempre condividono dati aggiornati e completi. Quando mancano informazioni affidabili, ritardi e variazioni della domanda devono essere trattati come ipotesi da simulare, non come previsioni certe sul comportamento dei partner.
Un esempio: ridurre le rotture di stock senza aumentare tutte le scorte
Consideriamo un distributore di componenti tecnici con 1.200 referenze e circa 80 ordini al giorno. Il titolare vuole ridurre le rotture di stock e migliorare il servizio, ma non sa se sia più conveniente aumentare le scorte, modificare le regole di riordino oppure riorganizzare le ubicazioni del magazzino. I numeri utilizzati in questo esempio sono ipotetici e hanno una finalità didattica.
Il primo passaggio consiste nel recuperare le informazioni già disponibili: movimenti di magazzino, ordini ricevuti, quantità consegnate dai fornitori, tempi di approvvigionamento e righe prelevate dagli operatori. Per ogni articolo occorre ricostruire la domanda nel tempo e verificare che le giacenze registrate corrispondano, per quanto possibile, alle quantità effettivamente presenti. Prima di introdurre sensori o acquistare una piattaforma tecnologica, è necessario capire se i dati disponibili siano sufficientemente completi e coerenti.
Una prima regola di gestione delle scorte è il punto di riordino, indicato con la sigla ROP (Reorder Point), che individua il livello di disponibilità al quale avviare un nuovo ordine di approvvigionamento.
La formula più semplice è:
[math]ROP=\mu_d \times L+SS[/math]
dove:
- [math]ROP[/math] rappresenta il punto di riordino;
- [math]\mu_d[/math] è la domanda media giornaliera;
- [math]L[/math] è il tempo medio di approvvigionamento, espresso in giorni;
- [math]SS[/math] è la scorta di sicurezza.
Supponiamo che un componente abbia una domanda media di 30 unità al giorno, che il fornitore impieghi mediamente 8 giorni per consegnare e che l’impresa voglia mantenere una scorta di sicurezza di 60 unità.
Il punto di riordino sarà:
[math]ROP=30\times8+60=300[/math]
Quando la posizione di magazzino raggiunge 300 unità, l’impresa dovrebbe avviare un nuovo ordine.
È importante precisare che la decisione non deve basarsi soltanto sulla giacenza fisica. La posizione di magazzino considera anche gli ordini già emessi e le quantità impegnate per soddisfare richieste dei clienti, così da evitare riordini duplicati o decisioni basate su una disponibilità soltanto apparente.
Quando domanda e lead time diventano variabili
La formula precedente è utile per introdurre il meccanismo del riordino, ma presuppone condizioni relativamente semplici. Nella realtà, la domanda giornaliera può cambiare e i fornitori possono consegnare con ritardi o anticipi rispetto ai tempi medi.
Quando domanda e lead time sono variabili, una possibile formulazione della scorta di sicurezza è:
[math]SS=z\sqrt{L\sigma_d^2+\mu_d^2\sigma_L^2}[/math]
dove:
- [math]z[/math] è il quantile della distribuzione normale associato al livello di servizio desiderato;
- [math]L[/math] è il lead time medio;
- [math]\sigma_d[/math] è la deviazione standard della domanda giornaliera;
- [math]\mu_d[/math] è la domanda media giornaliera;
- [math]\sigma_L[/math] è la deviazione standard del lead time.
La formula assume che la domanda giornaliera sia indipendente nel tempo, che la domanda e il lead time siano indipendenti tra loro e che le condizioni siano sufficientemente stabili. Se la domanda presenta stagionalità, autocorrelazione o una forte dipendenza dai tempi di approvvigionamento, occorre utilizzare un modello più adatto alle caratteristiche dei dati.
L’aspetto interessante è che la scorta di sicurezza non viene più stabilita soltanto attraverso una quantità scelta dall’impresa, ma dipende dalla variabilità del processo e dal livello di servizio che si vuole garantire.
Un modello di simulazione può utilizzare queste informazioni per confrontare politiche differenti, verificando quanto capitale aggiuntivo sia necessario per ridurre il rischio di indisponibilità dei prodotti.
Confrontare le alternative attraverso gli indicatori
Una volta costruito il modello, il distributore può confrontare almeno tre strategie: aumentare in modo generalizzato le scorte, assegnare scorte di sicurezza differenti alle varie referenze oppure intervenire sulle ubicazioni e sui percorsi di prelievo.
La prima alternativa potrebbe ridurre alcune rotture di stock, ma comporterebbe un maggiore immobilizzo di capitale e un possibile aumento del rischio di obsolescenza. La seconda consentirebbe di concentrare le risorse sugli articoli più importanti, considerando domanda, valore economico e criticità per il servizio. La terza potrebbe ridurre i tempi operativi e migliorare la produttività senza richiedere necessariamente nuovi acquisti di merce.
Il confronto deve basarsi su indicatori definiti con precisione. Il fill rate, per esempio, misura la quota di domanda soddisfatta immediatamente e può essere calcolato come rapporto tra quantità evasa e quantità richiesta nello stesso periodo:
[math]Fill\ Rate=\frac{\text{Quantità evasa}}{\text{Quantità richiesta}}\times100[/math]
Il livello di servizio può però essere misurato anche attraverso la percentuale di ordini o di righe d’ordine completati senza ritardi. Per questo motivo, un valore come il 93% di servizio non è sufficiente se non si specifica quale metrica sia stata utilizzata.
Anche una rottura di stock del 7% può assumere significati diversi a seconda che si riferisca agli articoli indisponibili, alle righe d’ordine interessate oppure alla quantità di domanda non soddisfatta. La definizione degli indicatori è quindi una parte essenziale del modello, perché metriche apparentemente simili possono portare a decisioni differenti.
A questi valori si possono affiancare il capitale immobilizzato nelle scorte, il valore dei prodotti obsoleti, il tempo medio di evasione, la produttività del picking e il costo delle vendite perse o ritardate. L’obiettivo non è individuare una strategia migliore in assoluto, ma capire quale alternativa offra il compromesso più conveniente tra disponibilità dei prodotti, capitale necessario e risorse operative.
Anche la rappresentazione della domanda non soddisfatta deve essere coerente con il comportamento reale dell’impresa. Se la quantità richiesta supera quella disponibile, il modello deve distinguere tra ordini che rimangono in arretrato e vendite definitivamente perse. Nel primo caso, la domanda non evasa continua a generare un fabbisogno futuro; nel secondo, viene registrata come opportunità commerciale non recuperata. Se queste quantità scompaiono dai calcoli, la simulazione sottostima proprio il problema che dovrebbe aiutare a risolvere.
Un progetto piccolo, verificabile e aggiornabile
Il primo ostacolo nell’introduzione di un Digital Twin spesso non è la mancanza di tecnologia, ma la frammentazione delle informazioni e delle responsabilità. Gli ordini possono essere registrati nel gestionale, le scorte aggiornate attraverso fogli di calcolo e i tempi effettivi di lavorazione conosciuti soltanto dagli operatori. Prima di costruire un modello occorre quindi capire quali dati esistono, con quale frequenza vengono aggiornati e quali persone conoscono le eccezioni che non compaiono nei sistemi informativi.
Il progetto dovrebbe partire da una domanda circoscritta. L’obiettivo generico di digitalizzare il magazzino non indica ancora quale problema si intenda risolvere, mentre una domanda come «che cosa accade al livello di servizio se il lead time del fornitore principale passa da otto a dodici giorni?» permette di identificare le variabili necessarie, costruire scenari e confrontare risultati.
Una volta definito il problema, si possono selezionare gli strumenti più adatti. Per un’analisi iniziale potrebbero bastare dati esportati dal gestionale, un database e un programma che calcoli gli scenari alternativi. Se il processo comprende code, risorse condivise e tempi di attesa, una simulazione a eventi discreti può essere una scelta appropriata; se invece occorre assegnare ordini a macchine con vincoli di capacità e disponibilità, potrebbe essere necessario affiancare un modello di ottimizzazione.
Python e le sue librerie rappresentano una possibilità interessante per realizzare prototipi, elaborare dati e sviluppare simulazioni personalizzate, ma non costituiscono un requisito indispensabile. La scelta degli strumenti deve seguire le caratteristiche del problema, le competenze disponibili e la possibilità di mantenere il modello nel tempo.
Un passaggio fondamentale riguarda la validazione. Il fatto che una simulazione produca grafici ordinati e risultati numericamente precisi non significa che rappresenti correttamente il processo aziendale. Il modello deve essere confrontato con dati reali, verificando che riesca a riprodurre con sufficiente accuratezza gli indicatori rilevanti per la decisione.
Supponiamo che un’impresa voglia simulare i tempi di evasione degli ordini. Un primo confronto potrebbe essere il seguente:
| Indicatore | Dati reali | Simulazione |
|---|---|---|
| Tempo medio di evasione | 4,8 giorni | 4,6 giorni |
| Ordini evasi entro 48 ore | 62% | 65% |
| Fill rate | 94% | 95% |
I valori sono ipotetici e servono a illustrare il confronto. Le differenze non dimostrano automaticamente che il modello sia adeguato: occorre verificare se gli scostamenti siano compatibili con l’utilizzo previsto e se il modello riproduca anche la variabilità dei risultati, non soltanto i valori medi.
È inoltre importante distinguere la calibrazione dalla validazione. Durante la calibrazione si regolano i parametri del modello affinché rappresenti in modo plausibile il comportamento osservato. La validazione richiede invece di verificare le prestazioni anche su dati o periodi che non sono stati utilizzati per costruire e calibrare il modello. In questo modo si riduce il rischio di ottenere una rappresentazione che descrive bene il passato, ma non riesce a riprodurre situazioni differenti.
Quando il prototipo si dimostra utile, l’impresa può valutare l’aggiornamento automatico attraverso collegamenti al gestionale, a un database o ai sistemi di produzione. Sensori e comunicazione con i macchinari diventano interessanti quando forniscono informazioni che migliorano concretamente la decisione.
Anche l’automazione deve essere introdotta con gradualità. Un sistema che suggerisce un nuovo punto di riordino non comporta gli stessi rischi di uno che invia ordini ai fornitori senza approvazione. Prima di affidare al modello decisioni operative servono limiti, responsabilità, controlli e possibilità di intervento umano.
Il Digital Twin cambia anche il lavoro
Un progetto di gemello digitale non riguarda soltanto chi sviluppa il software. Per collegare i dati alle decisioni servono persone che conoscano il processo, sappiano interpretare le informazioni e siano in grado di spiegare che cosa il modello rappresenta e quali aspetti lascia fuori.
Questa collaborazione può modificare le attività quotidiane di chi lavora nella produzione, nella logistica e nella pianificazione, perché alcune decisioni vengono affrontate attraverso il confronto esplicito tra scenari, anziché basarsi esclusivamente su procedure consolidate e conoscenze individuali.
Accanto alle competenze tradizionali acquistano importanza ruoli che combinano conoscenza operativa e capacità analitica. L’analista di processo ricostruisce flussi, tempi e vincoli; l’analista di dati prepara le informazioni e verifica che gli indicatori abbiano un significato condiviso; lo specialista di simulazione traduce il processo in un modello matematico e ne controlla le ipotesi.
Nelle imprese più strutturate, altre figure si occupano dell’integrazione tra gestionale, produzione e strumenti di analisi, mentre i responsabili della manutenzione dei dati e dei modelli verificano che la rappresentazione digitale rimanga aggiornata quando cambiano macchine, turni, procedure o condizioni operative.
Nelle PMI questi compiti non corrispondono necessariamente a nuove posizioni a tempo pieno. Possono essere distribuiti tra personale interno, consulenti e fornitori tecnologici, ma non dovrebbero essere affidati soltanto a chi sviluppa il software. Un operatore esperto può conoscere una particolare attrezzatura necessaria in determinate condizioni di produzione, mentre un addetto al magazzino può sapere che alcuni articoli richiedono tempi di prelievo differenti da quelli registrati nel gestionale. Se queste informazioni non vengono integrate, il modello rischia di essere formalmente ordinato ma distante dal funzionamento reale dell’impresa.
Per chi si forma o desidera cambiare professione, l’opportunità non consiste necessariamente nell’imparare ogni piattaforma disponibile. È più utile saper formulare una domanda misurabile, interpretare i dati, descrivere un processo e discutere le ipotesi di una simulazione con le persone che quel processo lo svolgono. Le competenze tecniche acquistano valore quando si accompagnano alla capacità di comunicare con le diverse funzioni aziendali e di riconoscere i limiti dei risultati.
Questa trasformazione richiede attenzione anche all’organizzazione del lavoro. Se i modelli vengono introdotti senza coinvolgere le persone che dovranno utilizzarli, possono essere percepiti come strumenti di controllo o come giudizi automatici sulla produttività. È quindi necessario chiarire quali decisioni il sistema supporta, quali dati utilizza e chi mantiene la responsabilità della scelta. Il gemello digitale dovrebbe rendere più comprensibili i processi, valorizzando l’esperienza di chi li conosce, anziché sostituirla con una rappresentazione astratta.
Che cosa cercano i recruiter quando assumono per un Digital Twin
Negli annunci di lavoro, il titolo di esperto di Digital Twin non identifica una professione standardizzata. Si incontrano denominazioni come Digital Twin Engineer, Factory Digital Twin Developer e Simulation Engineer, ma dietro queste definizioni possono esserci attività differenti: sviluppare modelli di simulazione, collegarli ai sistemi aziendali, integrare dati provenienti dai macchinari oppure tradurre i risultati in interventi sui processi produttivi.
Un esempio è rappresentato da un annuncio di Siemens Energy per una posizione di Factory Digital Twin Developer, nella quale la modellazione e la simulazione degli impianti vengono affiancate all’integrazione dei dati provenienti da sensori e sistemi industriali. Tra le competenze richieste compaiono strumenti di simulazione a eventi discreti come Plant Simulation, Python e SQL, sviluppo di API e pipeline dei dati, infrastrutture cloud e familiarità con protocolli industriali come MQTT e OPC UA. La posizione prevede inoltre la collaborazione con professionisti della produzione, dell’automazione e dell’analisi dei dati.
Annuncio di lavoro Siemens Energy – Factory Digital Twin Developer.
Si tratta di un esempio concreto, non di un elenco universale di requisiti né di una misura dell’intero mercato del lavoro. Le competenze richieste dipendono dal settore, dalla dimensione del progetto e dalle tecnologie già presenti nell’impresa.
Da queste descrizioni emerge comunque una combinazione ricorrente: serve una base tecnica in ingegneria, informatica o scienze dei dati, accompagnata dalla capacità di comprendere processi, macchine e flussi operativi. La simulazione da sola non basta se non si riesce a collegare il modello alle informazioni aziendali, mentre la programmazione perde gran parte del proprio valore se non risponde a una decisione concreta.
Nei progetti più avanzati entrano in gioco anche competenze di cloud computing, sicurezza informatica, integrazione tra sistemi IT e OT e gestione della qualità dei dati. Non tutte queste conoscenze sono necessarie per ogni posizione, ma la capacità di collaborare con specialisti di discipline differenti rappresenta un elemento importante.
Per chi desidera avvicinarsi a quest’area può essere più efficace costruire un profilo professionale a T, approfondendo una specializzazione come la simulazione industriale, l’integrazione dei dati o l’analisi dei processi e affiancandole competenze sufficienti per dialogare con le altre funzioni aziendali.
Un percorso dimostrabile potrebbe partire da un problema produttivo o logistico, proseguire con la preparazione di un dataset e la costruzione di un modello, per concludersi con il confronto tra risultati simulati e dati osservati. La capacità di spiegare le ipotesi, i limiti e le implicazioni economiche del progetto a un pubblico non tecnico sarebbe altrettanto importante della conoscenza degli strumenti utilizzati.
Nelle PMI, dove spesso non esiste un reparto dedicato ai Digital Twin, queste opportunità possono comparire sotto denominazioni professionali più ampie, come analista di processo, ingegnere di produzione, specialista dei dati industriali o consulente di simulazione. Per questo motivo, chi cerca lavoro dovrebbe leggere soprattutto le responsabilità e i requisiti degli annunci, senza fermarsi al titolo della posizione.
Quanto costa e quando conviene
L’introduzione di un Digital Twin comporta costi che dipendono dalla complessità del processo, dalla qualità delle informazioni disponibili e dal livello di integrazione desiderato. Le principali voci possono comprendere la pulizia e l’integrazione dei dati, lo sviluppo del modello, eventuali licenze software, sensori, infrastrutture informatiche, formazione del personale e manutenzione.
Tra i benefici possibili rientrano la riduzione dei fermi macchina, il contenimento delle scorte inutili, la diminuzione degli sprechi, un migliore utilizzo delle risorse e la riduzione dei ritardi nelle consegne. Per attribuire un valore economico a questi risultati occorre però partire da una situazione iniziale misurabile e definire un periodo di osservazione adeguato.
Non tutti i benefici hanno la stessa natura economica. La riduzione delle ore di fermo può tradursi in minori costi o in una maggiore capacità produttiva effettivamente utilizzata; una diminuzione delle scorte può liberare capitale circolante e ridurre il rischio di obsolescenza; una migliore gestione degli ordini può generare ricavi aggiuntivi se l’impresa riesce a evadere richieste che altrimenti avrebbe perso.
È importante evitare di conteggiare due volte lo stesso risultato. Per esempio, la riduzione delle scorte e il minore capitale immobilizzato sono due aspetti dello stesso miglioramento e non devono essere sommati come se rappresentassero necessariamente benefici indipendenti. Analogamente, un aumento della capacità produttiva non genera automaticamente maggiori ricavi se la domanda non è sufficiente ad assorbire la produzione aggiuntiva.
Una prima valutazione economica può essere effettuata attraverso il ritorno sull’investimento:
[math]ROI=\frac{Benefici-Costi}{Costi}\times100[/math]
Supponiamo che un progetto di Digital Twin comporti un investimento complessivo di 12.000 euro e produca benefici economici attribuibili pari a 18.000 euro nello stesso periodo considerato. Il ROI semplice sarà:
[math]ROI=\frac{18.000-12.000}{12.000}\times100=50\%[/math]
Il risultato indica un rendimento positivo rispetto ai costi considerati, ma la sua attendibilità dipende dalla qualità delle stime. I benefici devono essere effettivamente riconducibili al progetto, mentre nei costi occorre includere anche le spese ricorrenti, la manutenzione e le attività necessarie per mantenere aggiornato il modello.
Quando costi e benefici si distribuiscono su più anni, il ROI semplice non è sufficiente per valutare correttamente l’investimento, perché non considera il momento in cui si verificano i flussi finanziari. In questi casi è preferibile affiancare un’analisi del valore attuale netto, del tempo di recupero dell’investimento e della sensibilità dei risultati rispetto alle ipotesi principali.
Un ulteriore elemento riguarda il costo delle alternative. Se un Digital Twin permette di evitare l’acquisto di un macchinario da 85.000 euro, il beneficio potenziale non coincide automaticamente con l’intero valore dell’investimento evitato. Occorre verificare che la capacità produttiva possa essere garantita attraverso un intervento alternativo, senza generare costi maggiori o compromettere il servizio ai clienti.
Il Digital Twin non è quindi conveniente per ogni impresa e non sostituisce una buona gestione dei processi. Può diventare un investimento interessante quando esiste una decisione frequente o economicamente rilevante, quando le informazioni necessarie sono reperibili e quando l’impresa ha la possibilità di verificare se il modello produce un miglioramento concreto.
Una tecnologia utile solo se resta vicina alla realtà
La tentazione di costruire un modello sempre più dettagliato deve essere valutata con attenzione. Se la domanda riguarda il fabbisogno di un articolo, una rappresentazione numerica delle scorte potrebbe essere sufficiente; un modello tridimensionale diventa invece utile quando contano gli ingombri, la disposizione degli scaffali, le traiettorie dei robot o l’accessibilità degli spazi.
La complessità aggiuntiva è giustificata soltanto quando migliora la qualità della decisione o riduce un rischio concreto. Un modello molto dettagliato può richiedere più dati, maggiori capacità di calcolo e un’attività di manutenzione più impegnativa, senza garantire un miglioramento proporzionale dei risultati.
I rischi principali riguardano dati incompleti, ipotesi non dichiarate, dipendenza da strumenti difficili da mantenere e distanza tra il modello e le persone che svolgono il lavoro. Esiste inoltre il rischio che una rappresentazione costruita sui dati storici descriva correttamente il passato, ma perda progressivamente aderenza quando cambiano turni, macchine, procedure o condizioni della domanda.
La manutenzione del modello e la verifica periodica delle sue ipotesi devono quindi essere considerate parte integrante del progetto. Un Digital Twin non rimane attendibile soltanto perché è stato costruito correttamente: deve continuare a rappresentare un sistema che, nella realtà, cambia nel tempo.
Per una PMI il percorso più ragionevole potrebbe essere molto semplice: scegliere un problema, ricostruire le informazioni già disponibili, confrontare poche alternative e verificare i risultati insieme alle persone coinvolte. Se il prototipo dimostra di aiutare nelle decisioni, l’impresa potrà ampliarlo gradualmente, introducendo nuovi dati e collegamenti automatici; se non aggiunge valore, avrà comunque acquisito una conoscenza più precisa dei propri processi senza aver investito in una piattaforma sovradimensionata.
La simulazione non elimina l’incertezza e non sostituisce il giudizio imprenditoriale. Permette però di rendere più visibili le conseguenze delle scelte prima che queste diventino costi reali, offrendo a chi decide e a chi lavora strumenti più chiari per discutere le alternative.
La vera domanda, quindi, non è quanto sia sofisticato il gemello digitale che un’impresa può costruire, ma quanto riesca a migliorare le proprie decisioni grazie a quel modello. Un investimento tecnologico ha senso quando contribuisce a ridurre i rischi, liberare risorse o creare valore misurabile; tutto il resto rischia di trasformarsi in un progetto innovativo soltanto sulla carta.
Riferimenti per approfondire
- Döring, L., Trojahn, S. e Reusch, P. (2025), Partial Twin – Pragmatic Digital Twin Adoption for SMEs, 18th International Doctoral Students Workshop on Logistics, Supply Chain and Production Management. Scheda della pubblicazione.
- Wooley, A. et al. (2023), When is a simulation a digital twin? A systematic literature review, articolo su ScienceDirect.
- Koskinen, A. et al. (2026), Digital twin understanding and adoption in small- and medium-sized enterprises: a case study, articolo su Taylor & Francis.
Nota: gli esempi numerici dell’articolo sono scenari didattici ipotetici e non descrivono risultati di casi aziendali documentati.
📚Digital Twin, industria connessa e decisioni basate sui dati
Un gemello digitale non nasce soltanto da una rappresentazione virtuale di un impianto: richiede dati affidabili, integrazione tra sistemi, conoscenza dei processi e capacità di valutare gli effetti economici delle decisioni. Questi approfondimenti aiutano a comprendere le tecnologie e le competenze che rendono possibile questa trasformazione.
- 👉 Quanto costa davvero l’AI? Compute Allocation, costi, ROI e budget aziendale
Per valutare i costi complessivi delle tecnologie digitali, distinguere le spese infrastrutturali dai benefici e misurare il ritorno degli investimenti. - 👉 Black Swan: la matematica dell’imprevisto e il limite dei modelli predittivi
Per capire perché anche una simulazione ben costruita non può eliminare l’incertezza e quali rischi derivano dall’affidarsi troppo ai modelli. - 👉 Supply Chain 2026: chi è e cosa fa il Consulente Funzionale
Per approfondire la gestione dei flussi produttivi e logistici, la pianificazione delle scorte e l’utilizzo dei dati nelle decisioni operative. - 👉 Sviluppatore Backend IoT: la figura che collega software e mondo fisico
Per comprendere come sensori, gateway, protocolli industriali e piattaforme software trasformano i dati degli impianti in informazioni utilizzabili. - 👉 AI Engineer Industriale: cosa cerca davvero il mercato e come evolverà il lavoro
Per esplorare le competenze necessarie a integrare modelli AI, analisi dei dati e sistemi industriali in applicazioni concrete.


 La Legge di Conway: quando la struttura delle relazioni diventa struttura del sistema
 Il fax avrebbe dovuto vincere: quando il futuro prende una strada diversa
 Watermark AI: come riconoscere i testi generati dai modelli e perché non basta per capire chi li ha scritti
 Differenza tra AI Tool Literacy e AI Epistemic Literacy: come verificare le risposte dell'intelligenza artificiale
 Compute Economist: Chi È e Perché la Potenza di Calcolo sta Ridefinendo l'Economia dell’AI
 La matematica delle mode: modelli di Bass, reti sociali e Google Trends per analizzare i trend
 Agenti AI e società artificiali: come la meccanica statistica prevede consenso e polarizzazione
 Navier–Stokes e l'AI: 10.000 agenti e la nuova economia della scoperta scientifica
 Second-Order Thinking: la competenza invisibile che crea carriere esponenziali
 La dashboard della carriera: come misurare il capitale professionale e difendersi dai ghost job
 Inferenza Causale in Data Science: Cos'è e perché guida la Decision Intelligence
 Dalla Geometria al Multi-Agent Modeling: quando l'ottimizzazione diventa un fenomeno emergente